Implementation of the Robust Mixture Prior for normally distributed treatment effect
2026-10-03
Source:vignettes/methods/Gaussian_RMP.Rmd
Gaussian_RMP.RmdIntroduction
The aim of this document is to illustrate the implementation of the Robust Mixture Prior in the case where the treatment effect follows a normal distribution.
Load the Belimumab case study configuration
Load the simulation configuration and the Belimumab case study configuration from YAML files.
set.seed(42)
simulation_config <- yaml::yaml.load_file(system.file("conf/simulation_config.yml", package = "BExTE"))

case_study = "belimumab"
case_study_config <- yaml::yaml.load_file(system.file("conf/case_studies/belimumab.yml", package = "BExTE"))
Specific scenario
For a given case study, we will loop over different methods. Here, we choose the RMP for illustration. For the considered method, we also loop over target study sample size, drift, control drift, and method parameters.
Here, we choose the following :
method <- "RMP"
method_parameters <- list(
  initial_prior = "noninformative", # This corresponds to the fact that the posterior for the adults data is derived from an uninformative prior (for consistency with other methods). May be removed in future releases.
  prior_weight = 0.5, # weight on the informative component of the mixture
  empirical_bayes = FALSE # Corresponds to whether some parameters of the prior are based on observed data.
)

target_sample_size_per_arm <- as.integer(case_study_config$target$total / 2)
drift <- 0.4
The RMP is a mixture of two normal distributions:
Where:
- : treatment effect in the target study
- : source study data
- : vague component mean
- $^2_v $: vague component variance
- : estimate of the treatment effect in the source study
- : standard error on the treatment effect in the source study
The first component of the mixture is a vague (large variance) normal distribution. The second component corresponds to the posterior obtained by updating a vague (improper) prior based on source data. The target trial data are assumed sampled from , and is assumed known.
Create data objects
Create a source_data instance, where information about the source data is stored
source_data <- SourceData$new(case_study_config)
print(source_data$to_dict())
## $source_treatment_effect_estimate
## [1] 0.480132
##
## $source_standard_error
## [1] 0.1208303
##
## $endpoint
## [1] "binary"
##
## $summary_measure_likelihood
## [1] "normal"
##
## $source_sample_size_control
## [1] 562
##
## $source_sample_size_treatment
## [1] 563
##
## $equivalent_source_sample_size_per_arm
## [1] 562.4996
##
## $source_control_rate
## [1] 0.3879004
##
## $source_treatment_rate
## [1] 0.5059961Create an instance of the BinaryTargetData class, which will allow us to sample target study data. Note that this target_data depends on the specific parameters chosen for the scenario (in particular, the drift and target sample size).
summary_measure_likelihood <- case_study_config$summary_measure_likelihood
endpoint <- case_study_config$endpoint
target_data <- ObservedTargetData$new(treatment_effect_estimate = case_study_config$target$treatment_effect, treatment_effect_standard_error = case_study_config$target$standard_error, target_sample_size_per_arm = as.integer(case_study_config$target$total / 2), summary_measure_likelihood = case_study_config$summary_measure_likelihood)
Create the RMP model
Now, we define the model we want to use for inferring the treatment effect in the target study.
model <- Model$new()

model <- model$create(
  case_study_config = case_study_config,
  method = method,
  method_parameters = method_parameters,
  source_data = source_data
)
The model’s prior_pdf method is :
read_function_code(model$prior_pdf)## $ <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_prior, target_treatment_effect,
## log = FALSE))
## } model <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_prior, target_treatment_effect,
## log = FALSE))
## } prior_pdf <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_prior, target_treatment_effect,
## log = FALSE))
## }Inference with the RMP
To perform inference, we would simply use:
# Perform Bayesian inference based on observed target data.
model$inference(target_data = target_data)
## [1] "Success"This inference steps set the following attributes which, taken together, specify the posterior distribution.
model$print_model_summary()## Attribute Value
## Method RMP
## Prior Mean 0.240066
## Prior Variance 4.171164
## Posterior Mean 0.457303
## Posterior Variance 0.036794
## Posterior Median 0.467513
## Posterior prior weight 0.865272
## Prior Weight 0.500000
## Vague Posterior Mean 0.363198
## Vague Posterior Variance 0.176132
## Informative Posterior Mean 0.471956
## Informative Posterior Variance 0.0135045Now, let us see how this is implemented:
read_function_code(model$inference)## $ <- function (target_data)
## {
## self$empirical_bayes_update(target_data)
## self$posterior_moments(target_data)
## return("Success")
## } model <- function (target_data)
## {
## self$empirical_bayes_update(target_data)
## self$posterior_moments(target_data)
## return("Success")
## } inference <- function (target_data)
## {
## self$empirical_bayes_update(target_data)
## self$posterior_moments(target_data)
## return("Success")
## }The first step in inference is to update the prior based on target_data if needed, in case where the method uses empirical Bayes. With empirical Bayes, some parameters of the prior are set based on observed target data. The second step is to compute the moments of the treatment effect posterior distribution. Note that we use the same inference function for all methods/scenarios combinations that do not require MCMC (in which case we need samples from the posterior and not only the parameters of the posterior).
In the study protocol, we specified that the variance of the vague component of the RMP should be such that this prior corresponds to the information provided by a single subject per arm in the target study. This is a form of empirical Bayes:
read_function_code(model$empirical_bayes_update)## $ <- function (target_data)
## {
## if (self$empirical_bayes) {
## self$vague_prior_variance <- (target_data$sample$treatment_effect_standard_error^2) *
## target_data$sample_size_per_arm
## info <- c(self$w, self$info_prior_mean, sqrt(self$info_prior_variance))
## vague <- c(1 - self$w, self$vague_prior_mean, sqrt(self$vague_prior_variance))
## if (self$w == 1) {
## self$RBesT_prior <- RBesT::mixnorm(info = info)
## }
## else if (self$w == 0) {
## self$RBesT_prior <- RBesT::mixnorm(vague = vague)
## }
## else {
## self$RBesT_prior <- RBesT::mixnorm(info = info, vague = vague)
## }
## prior_summary <- summary(self$RBesT_prior)
## self$prior_mean <- prior_summary["mean"]
## self$prior_var <- prior_summary["sd"]^2
## RBesT::sigma(self$RBesT_prior) <- target_data$sample$standard_deviation
## self$RBesT_prior_normix <- self$RBesT_prior
## }
## else {
## if (is.null(self$vague_prior_variance)) {
## stop("The vague prior variance must be defined if empirical_bayes is False")
## }
## }
## } model <- function (target_data)
## {
## if (self$empirical_bayes) {
## self$vague_prior_variance <- (target_data$sample$treatment_effect_standard_error^2) *
## target_data$sample_size_per_arm
## info <- c(self$w, self$info_prior_mean, sqrt(self$info_prior_variance))
## vague <- c(1 - self$w, self$vague_prior_mean, sqrt(self$vague_prior_variance))
## if (self$w == 1) {
## self$RBesT_prior <- RBesT::mixnorm(info = info)
## }
## else if (self$w == 0) {
## self$RBesT_prior <- RBesT::mixnorm(vague = vague)
## }
## else {
## self$RBesT_prior <- RBesT::mixnorm(info = info, vague = vague)
## }
## prior_summary <- summary(self$RBesT_prior)
## self$prior_mean <- prior_summary["mean"]
## self$prior_var <- prior_summary["sd"]^2
## RBesT::sigma(self$RBesT_prior) <- target_data$sample$standard_deviation
## self$RBesT_prior_normix <- self$RBesT_prior
## }
## else {
## if (is.null(self$vague_prior_variance)) {
## stop("The vague prior variance must be defined if empirical_bayes is False")
## }
## }
## } empirical_bayes_update <- function (target_data)
## {
## if (self$empirical_bayes) {
## self$vague_prior_variance <- (target_data$sample$treatment_effect_standard_error^2) *
## target_data$sample_size_per_arm
## info <- c(self$w, self$info_prior_mean, sqrt(self$info_prior_variance))
## vague <- c(1 - self$w, self$vague_prior_mean, sqrt(self$vague_prior_variance))
## if (self$w == 1) {
## self$RBesT_prior <- RBesT::mixnorm(info = info)
## }
## else if (self$w == 0) {
## self$RBesT_prior <- RBesT::mixnorm(vague = vague)
## }
## else {
## self$RBesT_prior <- RBesT::mixnorm(info = info, vague = vague)
## }
## prior_summary <- summary(self$RBesT_prior)
## self$prior_mean <- prior_summary["mean"]
## self$prior_var <- prior_summary["sd"]^2
## RBesT::sigma(self$RBesT_prior) <- target_data$sample$standard_deviation
## self$RBesT_prior_normix <- self$RBesT_prior
## }
## else {
## if (is.null(self$vague_prior_variance)) {
## stop("The vague prior variance must be defined if empirical_bayes is False")
## }
## }
## }The posterior is given by :
where denotes the probability density function of a normal distribution with mean and variance , evaluated at .
The code to compute the posterior moments is the following :
read_function_code(model$posterior_moments)## $ <- function (target_data)
## {
## self$RBesT_posterior <- RBesT::postmix(self$RBesT_prior,
## m = target_data$sample$treatment_effect_estimate, se = target_data$sample$treatment_effect_standard_error)
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## if (self$w == 0) {
## self$wpost <- 0
## self$vague_posterior_mean <- self$RBesT_posterior[2]
## self$vague_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else if (self$w == 1) {
## self$wpost <- 1
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else {
## self$wpost <- self$RBesT_posterior[1]
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## self$vague_posterior_mean <- self$RBesT_posterior[5]
## self$vague_posterior_variance <- self$RBesT_posterior[6]^2
## }
## self$posterior_parameters$prior_weight <- self$wpost
## self$post_mean <- self$posterior_summary["mean"]
## self$post_var <- unname(self$posterior_summary["standard_deviation"]^2)
## self$post_median <- self$posterior_summary["median"]
## assert_single_number(self$post_mean)
## } model <- function (target_data)
## {
## self$RBesT_posterior <- RBesT::postmix(self$RBesT_prior,
## m = target_data$sample$treatment_effect_estimate, se = target_data$sample$treatment_effect_standard_error)
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## if (self$w == 0) {
## self$wpost <- 0
## self$vague_posterior_mean <- self$RBesT_posterior[2]
## self$vague_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else if (self$w == 1) {
## self$wpost <- 1
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else {
## self$wpost <- self$RBesT_posterior[1]
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## self$vague_posterior_mean <- self$RBesT_posterior[5]
## self$vague_posterior_variance <- self$RBesT_posterior[6]^2
## }
## self$posterior_parameters$prior_weight <- self$wpost
## self$post_mean <- self$posterior_summary["mean"]
## self$post_var <- unname(self$posterior_summary["standard_deviation"]^2)
## self$post_median <- self$posterior_summary["median"]
## assert_single_number(self$post_mean)
## } posterior_moments <- function (target_data)
## {
## self$RBesT_posterior <- RBesT::postmix(self$RBesT_prior,
## m = target_data$sample$treatment_effect_estimate, se = target_data$sample$treatment_effect_standard_error)
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## if (self$w == 0) {
## self$wpost <- 0
## self$vague_posterior_mean <- self$RBesT_posterior[2]
## self$vague_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else if (self$w == 1) {
## self$wpost <- 1
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## }
## else {
## self$wpost <- self$RBesT_posterior[1]
## self$info_posterior_mean <- self$RBesT_posterior[2]
## self$info_posterior_variance <- self$RBesT_posterior[3]^2
## self$vague_posterior_mean <- self$RBesT_posterior[5]
## self$vague_posterior_variance <- self$RBesT_posterior[6]^2
## }
## self$posterior_parameters$prior_weight <- self$wpost
## self$post_mean <- self$posterior_summary["mean"]
## self$post_var <- unname(self$posterior_summary["standard_deviation"]^2)
## self$post_median <- self$posterior_summary["median"]
## assert_single_number(self$post_mean)
## }With :
read_function_code(model$posterior_mean)## $ <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["mean"])
## } model <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["mean"])
## } posterior_mean <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["mean"])
## }and :
read_function_code(model$posterior_variance)## $ <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["standard_deviation"]^2)
## } model <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["standard_deviation"]^2)
## } posterior_variance <- function ()
## {
## inference_results <- summary(self$RBesT_posterior)
## names(inference_results) <- c("mean", "standard_deviation",
## "cri95L", "median", "cri95U")
## self$posterior_summary <- inference_results
## return(self$posterior_summary["standard_deviation"]^2)
## }A crucial aspect of this inference step is the computation of the posterior mixture weights:
The posterior weight of the vague component is given by:
Where and are proportional to the marginal likelihood (or prior predictive probability) of the aggregate data for each Gaussian component: and :
This allows us to compute the posterior cdf and posterior pdf :
read_function_code(model$posterior_pdf)## $ <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_posterior, target_treatment_effect,
## log = FALSE))
## } model <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_posterior, target_treatment_effect,
## log = FALSE))
## } posterior_pdf <- function (target_treatment_effect)
## {
## return(RBesT::dmix(self$RBesT_posterior, target_treatment_effect,
## log = FALSE))
## }
read_function_code(model$posterior_cdf)## $ <- function (target_treatment_effect)
## {
## return(RBesT::pmix(self$RBesT_posterior, target_treatment_effect,
## lower.tail = TRUE, log.p = FALSE))
## } model <- function (target_treatment_effect)
## {
## return(RBesT::pmix(self$RBesT_posterior, target_treatment_effect,
## lower.tail = TRUE, log.p = FALSE))
## } posterior_cdf <- function (target_treatment_effect)
## {
## return(RBesT::pmix(self$RBesT_posterior, target_treatment_effect,
## lower.tail = TRUE, log.p = FALSE))
## }Let us plot the posterior pdf :
model$plot_pdfs(xmin = -0.5, xmax = 1.5, resolution = 100)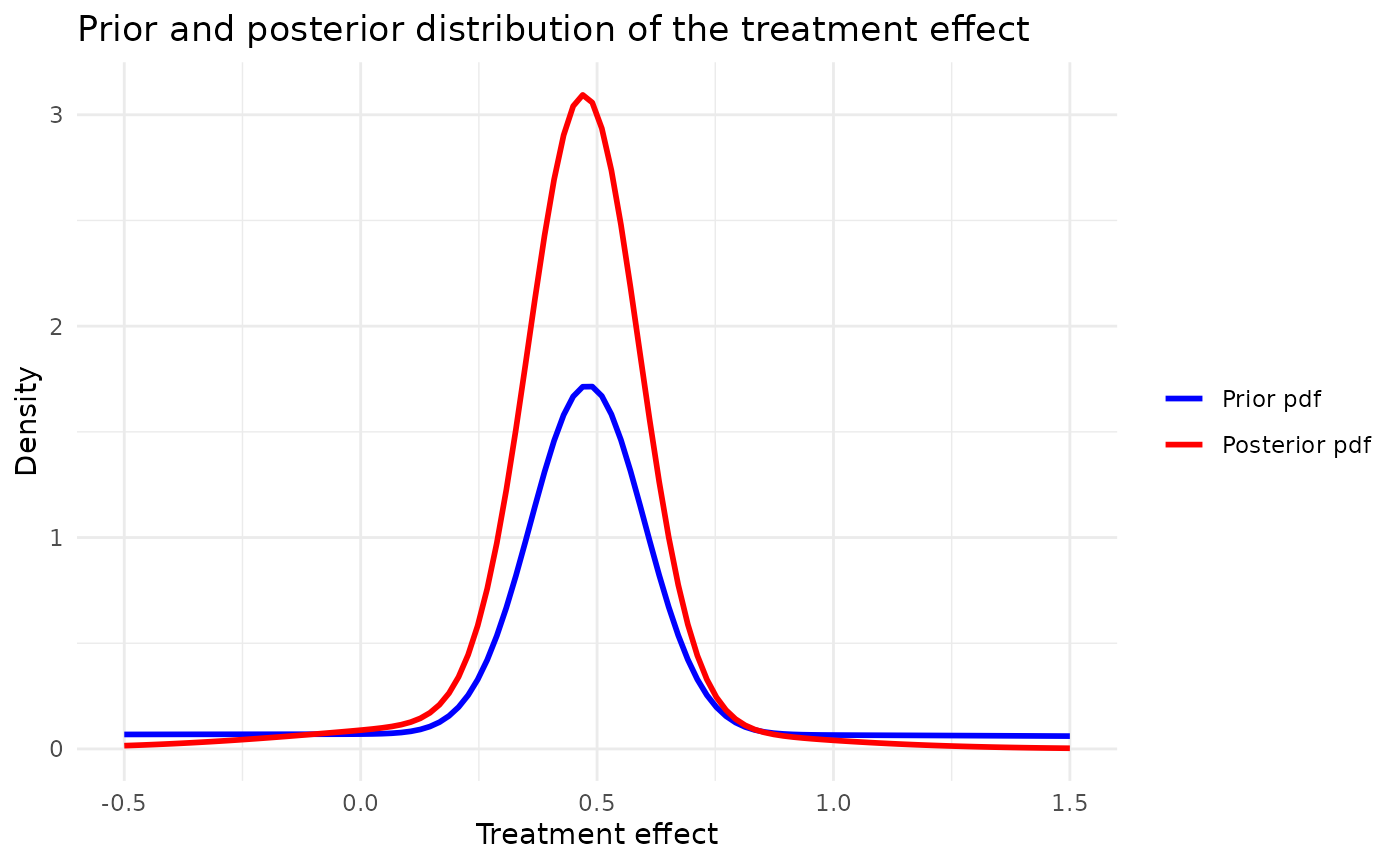
Being able to sample from the posterior is crucial for estimating quantiles, we use the following:.
read_function_code(model$sample_posterior)## $ <- function (n_samples)
## {
## samples <- RBesT::rmix(self$RBesT_posterior, n = n_samples)
## return(samples)
## } model <- function (n_samples)
## {
## samples <- RBesT::rmix(self$RBesT_posterior, n = n_samples)
## return(samples)
## } sample_posterior <- function (n_samples)
## {
## samples <- RBesT::rmix(self$RBesT_posterior, n = n_samples)
## return(samples)
## }Illustration of this sampling approach:
samples <- model$sample_posterior(10000)
hist(samples, breaks = 60, col = "skyblue", main = "Samples from the posterior distribution of the treatment effect", xlab = "Treatment effect", ylab = "Number of samples")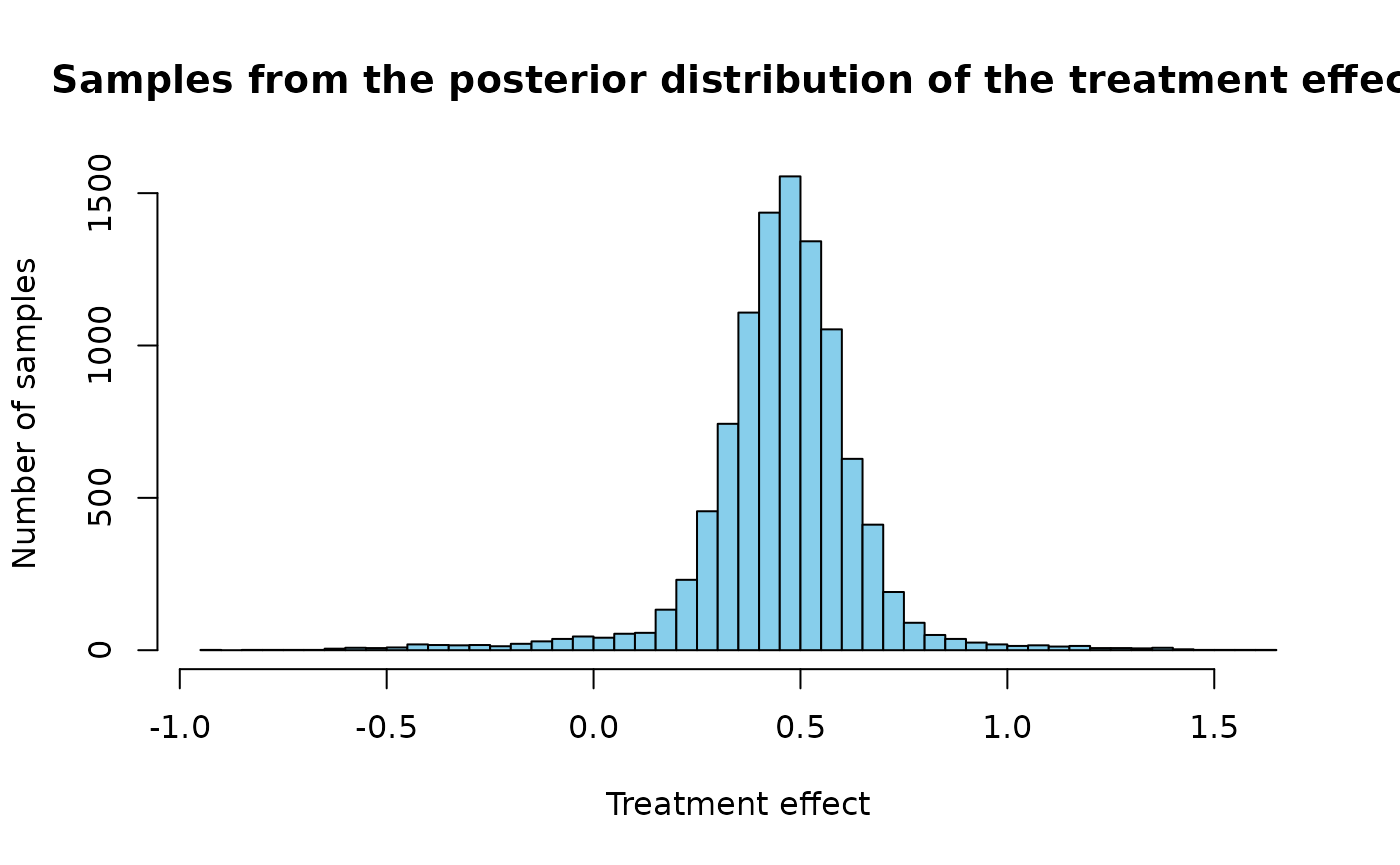
Simulation
Separate analysis (for comparison):
separate_method <- "separate"
method_parameters <- list(
  initial_prior = "noninformative", # This corresponds to the fact that the posterior for the adults data is derived from an uninformative prior (for consistency with other methods).
  empirical_bayes = FALSE # Corresponds to whether some parameters of the prior are based on observed data.
)

separate_model <- Model$new()

separate_model <- separate_model$create(
  case_study_config = case_study_config,
  method = separate_method,
  method_parameters = method_parameters,
  source_data = source_data
)
treatment_effect_values <- seq(-7, 2, length.out = 200)

n <- length(treatment_effect_values)
confidence_level <- simulation_config$confidence_level
null_space <- case_study_config$null_space

n_replicates <- 100

separate_test_decisions <- matrix(rep(0, n * n_replicates), nrow = n)
separate_posterior_means <- matrix(rep(0, n * n_replicates), nrow = n)
separate_posterior_medians <- matrix(rep(0, n * n_replicates), nrow = n)
separate_credible_intervals <- array(rep(0, n * n_replicates * 2), dim = c(n, n_replicates, 2))
separate_prior_proba_no_benefit <- rep(0, n)

theta_0 <- case_study_config$theta_0

critical_value <- simulation_config$critical_value


for (i in seq_along(treatment_effect_values)) {
  drift <- treatment_effect_values[i] - source_data$treatment_effect_estimate
  target_data <- TargetDataFactory$new()

  target_data <- target_data$create(source_data = source_data, case_study_config = case_study_config, target_sample_size_per_arm = target_sample_size_per_arm, treatment_drift = drift, summary_measure_likelihood = source_data$summary_measure_likelihood)

  results <- separate_model$simulation_for_given_treatment_effect(target_data = target_data, n_replicates = n_replicates, critical_value = critical_value, theta_0 = theta_0, confidence_level = confidence_level, null_space = null_space, to_return = c("test_decision", "posterior_mean", "posterior_median", "credible_interval"), verbose = 0, method = method, case_study = case_study, n_samples_quantiles_estimation = simulation_config$n_samples_quantiles_estimation)

  separate_test_decisions[i, ] <- results$test_decisions
  separate_posterior_means[i, ] <- results$posterior_means
  separate_posterior_medians[i, ] <- results$posterior_medians
  separate_credible_intervals[i, , ] <- matrix(results$credible_intervals, nrow = n_replicates)
}
test_decisions <- matrix(rep(0, n * n_replicates), nrow = n)
posterior_means <- matrix(rep(0, n * n_replicates), nrow = n)
posterior_medians <- matrix(rep(0, n * n_replicates), nrow = n)
credible_intervals <- array(rep(0, n * n_replicates * 2), dim = c(n, n_replicates, 2))
prior_proba_no_benefit <- rep(0, n)

for (i in seq_along(treatment_effect_values)) {
  drift <- treatment_effect_values[i] - source_data$treatment_effect_estimate # This implies that target_data$treatment_effect <- treatment_effect_values[i]
  target_data <- TargetDataFactory$new()

  target_data <- target_data$create(source_data = source_data, case_study_config = case_study_config, target_sample_size_per_arm = target_sample_size_per_arm, treatment_drift = drift, summary_measure_likelihood = source_data$summary_measure_likelihood)

  # target_data$sampling_approximation <- TRUE
  results <- model$simulation_for_given_treatment_effect(target_data = target_data, n_replicates = n_replicates, critical_value = critical_value, theta_0 = theta_0, confidence_level = confidence_level, null_space = null_space, to_return = c("test_decision", "posterior_mean", "posterior_median", "credible_interval"), verbose = 0,  method = method, case_study = case_study, n_samples_quantiles_estimation = simulation_config$n_samples_quantiles_estimation)

  test_decisions[i, ] <- results$test_decisions
  posterior_means[i, ] <- results$posterior_means
  posterior_medians[i, ] <- results$posterior_medians
  credible_intervals[i, , ] <- matrix(results$credible_intervals, nrow = n_replicates)
}
conditional_proba_success <- rowMeans(test_decisions) # Contains Pr(Study success | theta_T)
data <- data.frame(conditional_proba_success = conditional_proba_success, treatment_effect_values = treatment_effect_values, method = method)

separate_conditional_proba_success <- rowMeans(separate_test_decisions) # Contains Pr(Study success | theta_T)

separate_data <- data.frame(conditional_proba_success = separate_conditional_proba_success, treatment_effect_values = treatment_effect_values, method = separate_method)

combined_data <- rbind(data, separate_data)

plt <- ggplot(combined_data, aes(x = treatment_effect_values, y = conditional_proba_success, color = method)) +
  geom_point() +
  ggplot2::labs(
    title = "Posterior mean vs Target Treatment Effect",
    x = "Target Treatment Effect",
    y = "Success probability",
    color = "Method"
  ) +
  theme_minimal()

print(plt)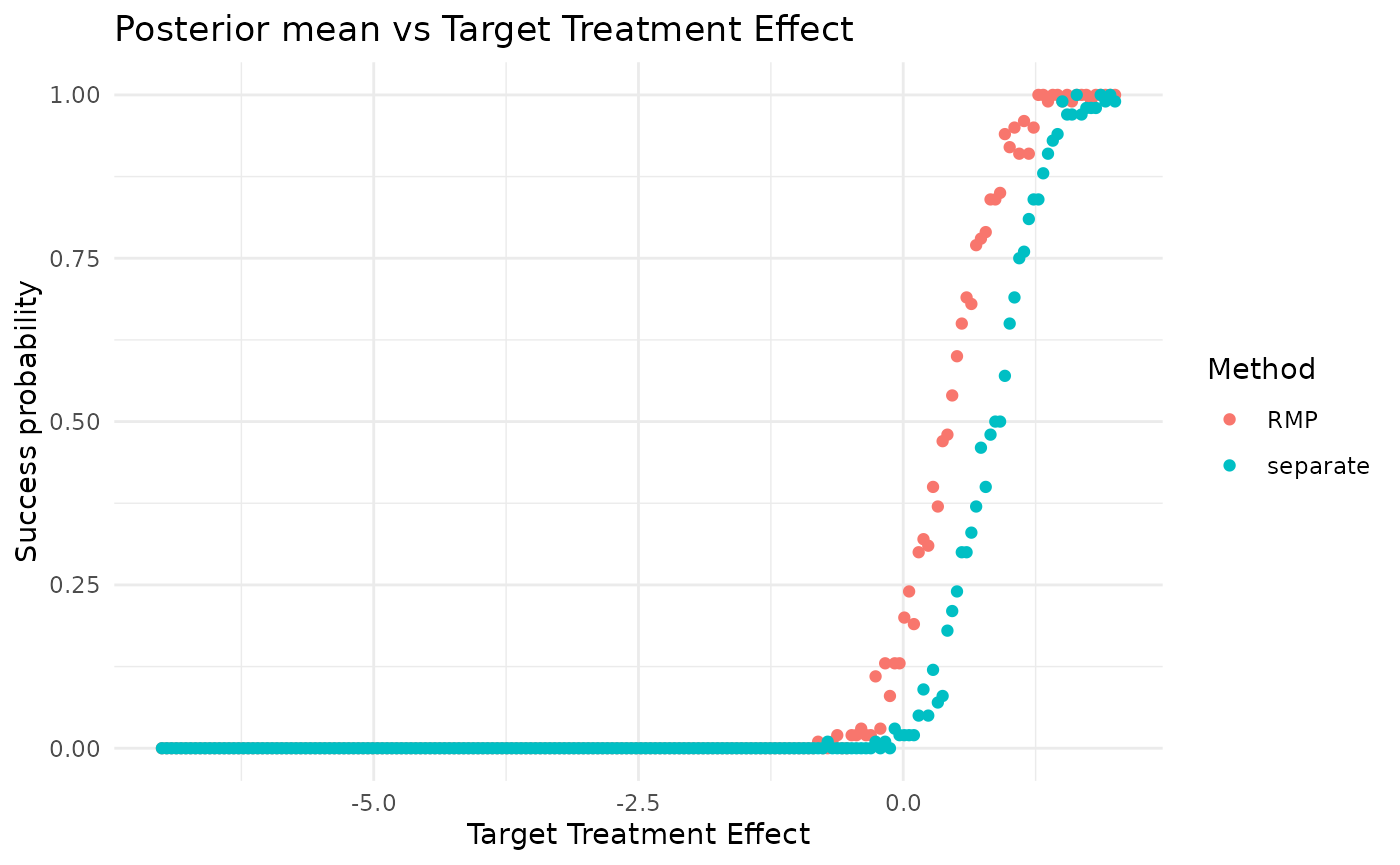
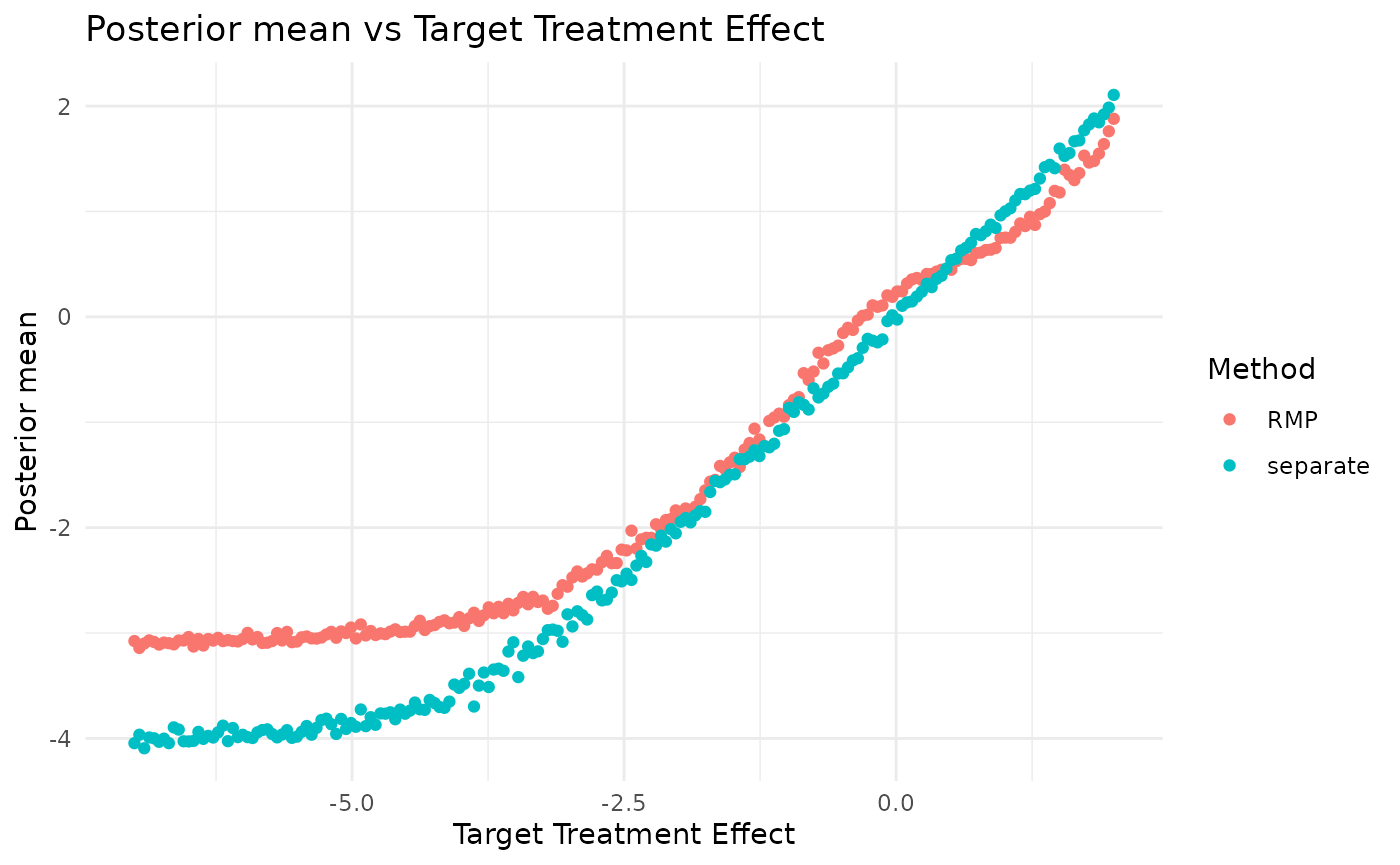
separate_conditional_posterior_means <- rowMeans(separate_posterior_means)
separate_data <- data.frame(conditional_posterior_means = separate_conditional_posterior_means, treatment_effect_values = treatment_effect_values, method = separate_method)

conditional_posterior_means <- rowMeans(posterior_means)
data <- data.frame(conditional_posterior_means = conditional_posterior_means, treatment_effect_values = treatment_effect_values, method = method)

combined_data <- rbind(data, separate_data)

plt <- ggplot(combined_data, aes(x = treatment_effect_values, y = conditional_posterior_means, color = method)) +
  geom_point() +
  ggplot2::labs(
    title = "Posterior mean vs Target Treatment Effect",
    x = "Target Treatment Effect",
    y = "Posterior mean",
    color = "Method"
  ) +
  theme_minimal()

print(plt)